
مکانیابی ایستگاه شارژ خودروی برقی: کجا بسازیم، چقدر بزرگ؟
چگونه یک مدل برنامهریزی عدد صحیح مختلط، محل و ظرفیت ایستگاههای شارژ سریع خودروی برقی را همزمان با ظرفیت فیدر شبکه توزیع برق تعیین میکند.
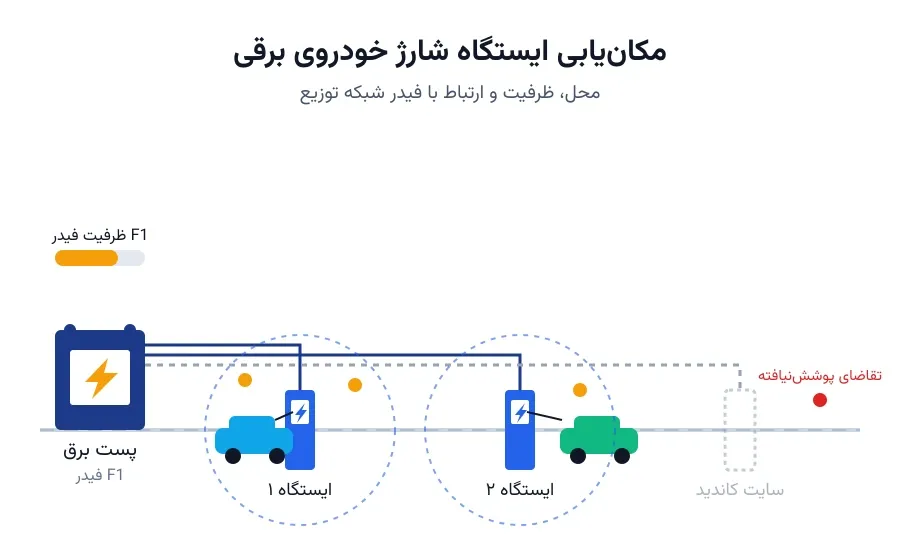
یک شهرداری میخواهد ده ایستگاه شارژ سریع در سطح شهر بسازد. بودجه محدود است و نمیتوان همهجا ایستگاه گذاشت. اگر ایستگاهها خیلی پراکنده باشند، بعضی محلهها بدون پوشش میمانند. اگر خیلی متمرکز باشند، فیدر محلی برق ممکن است ظرفیت کافی نداشته باشد. این دقیقاً همان تنشی است که مهندسان شهری و شرکتهای برق هر روز با آن روبهرو هستند.
سؤال اصلی دو بخش دارد. اول، ایستگاهها دقیقاً کجا ساخته شوند تا بیشترین تقاضای رانندگان را پوشش دهند؟ دوم، هر ایستگاه چه ظرفیتی داشته باشد تا هم تقاضای محلی را جواب دهد و هم فیدر تغذیهکنندهاش اضافهبار نشود؟ این دو تصمیم معمولاً جدا از هم گرفته میشوند. اما در عمل، این دو کاملاً به هم وابستهاند.
چرا این مسئله فقط یک مکانیابی ساده نیست
در پژوهش عملیاتی، مسئله مکانیابی تسهیلات برای پوشش حداکثری تقاضا شناختهشده است. یادداشت مکانیابی پایگاه آمبولانس دقیقاً همین منطق پوشش را برای امداد بررسی کرده است. اما آنجا محدودیت اصلی، تعداد آمبولانس و زمان پاسخ است. اینجا محدودیت اصلی، ظرفیت فیزیکی شبکه برق پشت هر ایستگاه است.
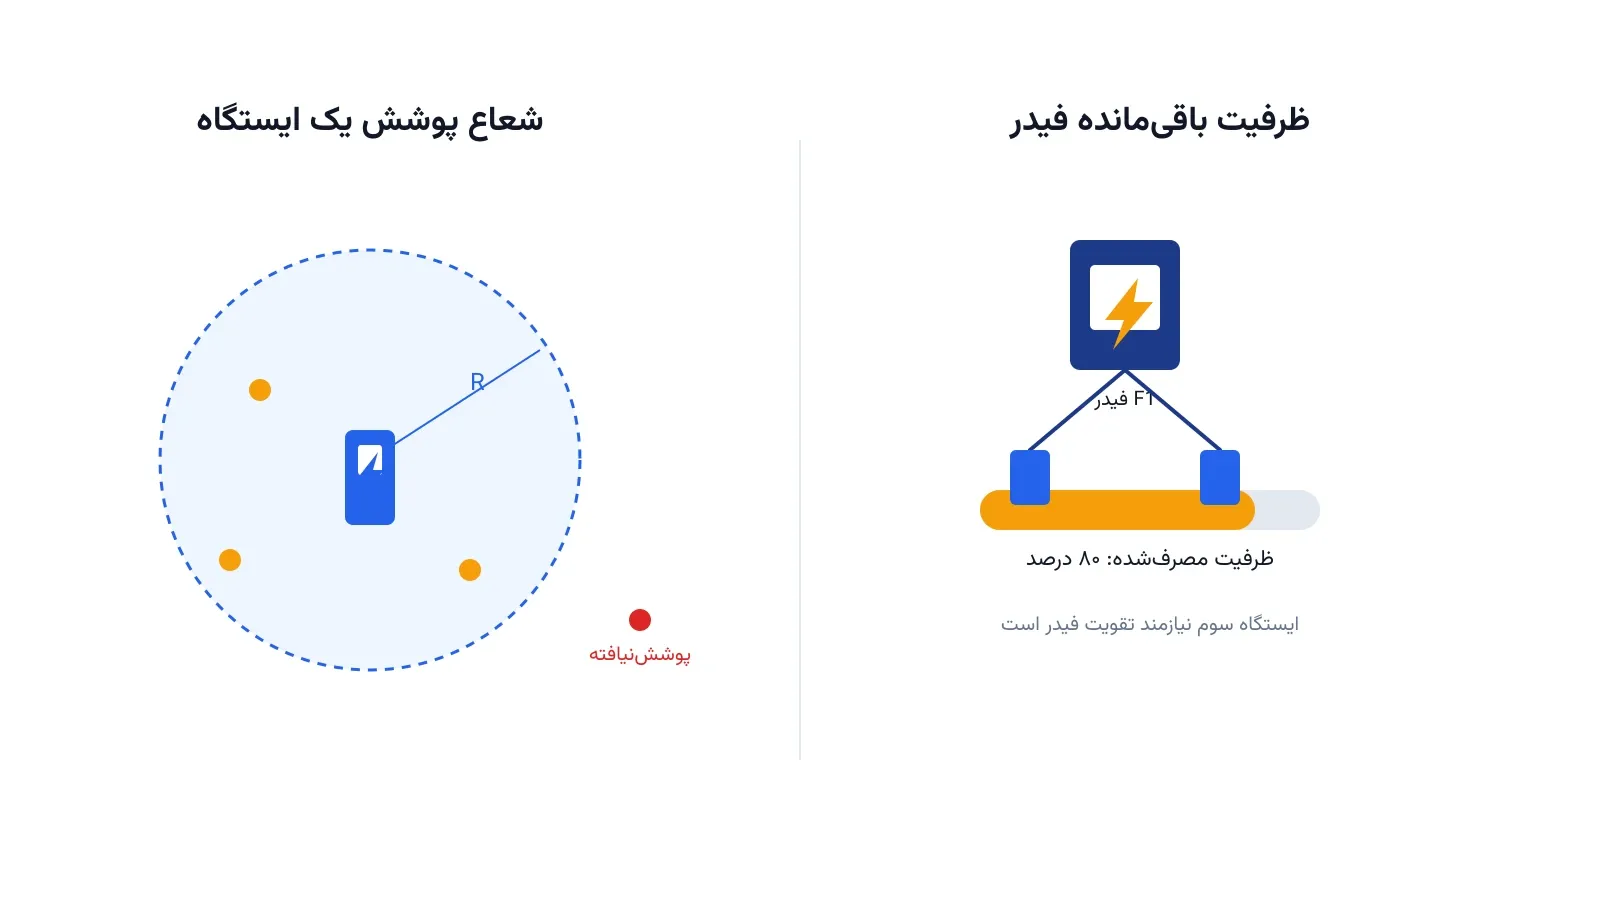
هر ایستگاه شارژ سریع به یک فیدر توزیع متصل است. آن فیدر، ظرفیت باقیمانده محدودی برای بار جدید دارد. اگر چند ایستگاه پرقدرت روی یک فیدر متمرکز شوند، باید فیدر تقویت شود. این تقویت، هزینه سنگینی به پروژه اضافه میکند. پس مدل مکانیابی خوب، باید این هزینه پنهان را هم ببیند، نه فقط فاصله تا مشتری.
فرمولبندی ریاضی مسئله
فرض کنید مجموعه سایتهای کاندید برای ساخت ایستگاه باشد و مجموعه نواحی تقاضا. هر ناحیه روزانه کیلوواتساعت تقاضای شارژ دارد. متغیر دودویی نشان میدهد آیا ایستگاه ساخته میشود. متغیر دودویی هم نشان میدهد ناحیه توسط ایستگاه پوشش داده میشود.
هر ناحیه تقاضا باید توسط دقیقاً یک ایستگاه، در شعاع مجاز ، پوشش داده شود:
یک ناحیه فقط میتواند به ایستگاهی وصل شود که واقعاً ساخته شده باشد:
ظرفیت نصبشده هر ایستگاه، متغیر پیوسته است. این ظرفیت باید کل تقاضای تخصیصیافته به آن ایستگاه را پوشش دهد:
نکته کلیدی مدل، قید ظرفیت فیدر است. هر ایستگاه به یک فیدر مشخص وصل است. مجموع ظرفیت نصبشده همه ایستگاههای روی یک فیدر، نباید از ظرفیت باقیمانده آن فیدر بیشتر شود، مگر با تقویت اضافه :
تابع هدف، مجموع هزینه ساخت، هزینه ظرفیت و هزینه تقویت فیدر را کمینه میکند:
این مدل، یک برنامهریزی عدد صحیح مختلط با متغیرهای دودویی و پیوسته است. اندازه آن برای یک شهر متوسط، چند صد تا چند هزار متغیر میشود. این ابعاد، کاملاً برای سالورهای متنباز قابل حل است.
اهمیت این موضوع
رشد خودروهای برقی، این تصمیم را فوریتر از همیشه کرده است. شرکتی مثل تسلا، شبکه سوپرچارجر خودش را در سراسر دنیا با همین منطق مکانیابی گسترش میدهد. هر ایستگاه جدید باید هم تقاضای مسیرهای پرتردد را پوشش دهد و هم به برق کافی دسترسی داشته باشد. انتخاب اشتباه محل، یعنی صف طولانی در یک ایستگاه و ظرفیت بلااستفاده در ایستگاه دیگر.
از طرف شرکتهای برق هم، هر ایستگاه شارژ سریع مثل یک مصرفکننده صنعتی کوچک رفتار میکند. اگر چند ایستگاه همزمان روی یک فیدر قدیمی نصب شوند، ترانسفورماتور محلی ممکن است اضافهبار شود. شرکتهای توزیع برق باید این بار جدید را از قبل پیشبینی کنند. مدل مکانیابی مشترک، دقیقاً همین هماهنگی بین شهرداری، سرمایهگذار ایستگاه و شرکت برق را ممکن میکند.
ظرفیت کار آکادمیک و پژوهشی
این مسئله، فضای پژوهشی تازه و نسبتاً کمکاری دارد. یک مسیر پژوهشی، مدلسازی عدمقطعیت تقاضای شارژ در طول روز است. چون الگوی شارژ در ساعتهای اوج، با ساعتهای کمترافیک خیلی فرق دارد.
مسیر دیگر، ترکیب این مدل با برنامهریزی توسعه شبکه توزیع است. یعنی همزمان تصمیم بگیریم کجا فیدر جدید بکشیم و کجا ایستگاه شارژ بسازیم. مسیر سوم، افزودن ذخیرهساز باتری ثابت به هر ایستگاه است. این ذخیرهساز میتواند پیک تقاضا را از دید فیدر پنهان کند. هرکدام از این مسیرها، گزینه خوبی برای پایاننامه یا مقاله است.
پیادهسازی با پایتون
خبر خوب این است که این مدل نیازی به نرمافزار گرانقیمت ندارد. مدل اصلی یک برنامهریزی عدد صحیح مختلط ساده است. این کلاس مسائل را میتوان با PuLP یا Pyomo نوشت. سالورهای متنباز مثل CBC یا HiGHS آن را در چند ثانیه حل میکنند.
import pulp

sites = ["A", "B", "C"]
zones = ["Z1", "Z2", "Z3", "Z4"]
demand = {"Z1": 120, "Z2": 90, "Z3": 150, "Z4": 80}
feeder_of = {"A": "F1", "B": "F1", "C": "F2"}
headroom = {"F1": 220, "F2": 200}
covers = {"Z1": ["A"], "Z2": ["A", "B"], "Z3": ["B", "C"], "Z4": ["C"]}
build_cost = {"A": 40000, "B": 35000, "C": 38000}
cap_cost, grid_cost, max_stations = 15, 60, 2

model = pulp.LpProblem("ev_siting", pulp.LpMinimize)
y = pulp.LpVariable.dicts("y", sites, cat="Binary")
x = pulp.LpVariable.dicts("x", [(i, j) for i in zones for j in covers[i]], cat="Binary")
q = pulp.LpVariable.dicts("q", sites, lowBound=0)
u = pulp.LpVariable.dicts("u", set(feeder_of.values()), lowBound=0)

model += (
    pulp.lpSum(build_cost[j] * y[j] for j in sites)
    + cap_cost * pulp.lpSum(q[j] for j in sites)
    + grid_cost * pulp.lpSum(u[s] for s in u)
)

for i in zones:
    model += pulp.lpSum(x[i, j] for j in covers[i]) == 1
    for j in covers[i]:
        model += x[i, j] <= y[j]

for j in sites:
    model += pulp.lpSum(demand[i] * x[i, j] for i in zones if j in covers[i]) <= q[j]
    model += q[j] <= 500 * y[j]

for s in u:
    model += pulp.lpSum(q[j] for j in sites if feeder_of[j] == s) <= headroom[s] + u[s]

model += pulp.lpSum(y[j] for j in sites) <= max_stations
model.solve(pulp.PULP_CBC_CMD(msg=False))

for j in sites:
    print(j, "ساخته شود" if y[j].value() > 0.5 else "ساخته نشود", q[j].value())
روی این مثال کوچک، سالور معمولاً دو سایت با فیدرهای متفاوت را انتخاب میکند. این انتخاب، فشار روی یک فیدر واحد را کم میکند. برای شبکه واقعی، کافی است فهرست سایتها و نواحی از داده واقعی شهر خوانده شود.
برای محاسبه فاصله واقعی بین هر ناحیه تقاضا و هر سایت کاندید، کتابخانه NetworkX روی شبکه معابر شهر مفید است. برای بررسی دقیقتر ظرفیت فیدر و افت ولتاژ، کتابخانه pandapower شبیهسازی شبکه توزیع را هم فراهم میکند. دوره بهینهسازی پیشرفته سیستم قدرت دقیقاً همین نوع مدلهای سرمایهگذاری زیرساخت را با کد پایتون پوشش میدهد.
داده ورودی مدل را میتوان از یک فایل اکسل یا CSV خواند. این فایل باید شامل مختصات نواحی تقاضا، سایتهای کاندید و ظرفیت باقیمانده هر فیدر باشد. پس از حل مدل، خروجی دقیقاً مشخص میکند کدام سایت ساخته شود و با چه ظرفیتی.
سوالات متداول
آیا این مدل فقط برای شهرهای بزرگ کاربرد دارد؟
نه. حتی یک شهرک صنعتی یا یک شبکه جادهای بینشهری کوچک هم از این مدل سود میبرد. اندازه مدل کاملاً به تعداد سایتهای کاندید بستگی دارد.
برای یادگیری این نوع مدلهای سرمایهگذاری زیرساخت برق از کجا شروع کنم؟
دوره بهینهسازی پیشرفته سیستم قدرت دقیقاً همین مسائل مکانیابی و برنامهریزی سرمایهگذاری شبکه را با کد پایتون آموزش میدهد.
آیا حتماً باید داده واقعی فیدرهای شبکه توزیع را داشته باشیم؟
دقت مدل به کیفیت داده ظرفیت فیدر بستگی دارد. بدون این داده، مدل فقط پوشش تقاضا را بهینه میکند، نه هماهنگی با شبکه برق.
اگر بخواهیم این مدل را برای شبکه شهر یا شرکت خودمان پیادهسازی کنیم؟
هر شهر الگوی تردد و ظرفیت فیدر خاص خودش را دارد. برای طراحی مدل اختصاصی متناسب با داده واقعی، میتوانید از طریق مشاوره جزئیات پروژه را مطرح کنید.
مشاوره و ارتباط با ما
برای مشاوره و ثبتنام در دورهها و دریافت پروژهها با آیدی @pypyid در تلگرام در تماس باشید.
مطالب پیشنهادی
دورههای آموزشی مرتبط
آموزش پیشرفته بهینهسازی سیستم قدرت با پایتون
آموزش پروژهمحور بهینهسازی سیستم قدرت در پایتون با Pyomo: Unit Commitment، پخش بار بهینه DC و AC (OPF)، امنیت N-1، جایابی باتری و عدم قطعیت؛ ۲۲ ساعت.
آموزش مقدماتی بهینهسازی سیستمهای قدرت
شروع بهینهسازی سیستمهای قدرت در ۸ ساعت با پایتون: پخش بار اقتصادی، DC-OPF، مدلسازی باتری و مقدمه Unit Commitment؛ مناسب دانشجویان و پژوهشگران برق.
دوره جامع بهینهسازی و تصمیمگیری سیستم سلامت با پایتون
دوره جامع و پروژه محور بهینهسازی و تصمیمگیری سیستم سلامت با پایتون و OR-Tools؛ ۲۰ پروژه عملی از تخصیص تخت بیمارستان تا امداد پهپادی به مناطق آسیبدیده.
آموزش مسیریابی وسایل نقلیه (VRP) با پایتون و OR-Tools
دوره پروژهمحور VRP در پایتون با OR-Tools و CP-SAT؛ ۲۰ پروژه عملی از TSP و CVRP تا VRPTW و مسیریابی خودروی الکتریکی.
مقالات و یادداشتهای مرتبط
چه مسائلی به AC-OPF نیاز دارند؟
معرفی ۱۰ مطالعهی مهم در سیستم قدرت که به دلیل نیاز به ولتاژ، توان راکتیو یا تلفات دقیق، فقط با پخش بار AC قابل انجام هستند.
اعزام آمبولانس: کدام پایگاه، به کدام حادثه، در کمترین زمان؟
چگونه بهینهسازی و مدلهای پوشش احتمالاتی به تصمیم مکانیابی پایگاه و اعزام آمبولانس در شرایط عدمقطعیت تقاضا کمک میکنند.
جابهجایی پویای آمبولانس: کجا منتظر بمانیم تا زودتر برسیم؟
آشنایی با مسئله مکانیابی و جابهجایی پویای آمبولانس در خدمات اورژانس پزشکی، و مدلسازی آن با ابزارهای متنباز پایتون.
زمانبندی تولید با ظرفیت روزانه متغیر در CP-SAT
هر سفارش چند روز پیاپی کوره را اشغال میکند و ظرفیت روزانه هم متغیر است. این مسئلهٔ زمانبندی منابع محدود را با CP-SAT مدل و حل میکنیم.
پروژههای مرتبط
جایابی باتری برای کاهش هدررفت تجدیدپذیرها
جایابی بهینه ایستگاههای ذخیرهسازی انرژی در شبکه انتقال برای کاهش هدررفت تولیدات تجدیدپذیر و بهبود بهرهبرداری با استفاده از مدلسازی ریاضی.
مدیریت انرژی شهرک با خورشیدی، باتری و خودروی برقی (V2G)
دیسپچ بهینهٔ پنل خورشیدی، باتری خانگی و مشترک، و شارژ دوطرفهٔ خودروی برقی (V2G) در یک شهرک ۷۵ خانهای، با محدودیت ظرفیت فیدر و کاهش پیک.
مسیریابی پویا (Dynamic VRP): بازبرنامهریزی زمانواقعی
سیستم مسیریابی پویا (Dynamic VRP) که با رسیدن سفارش جدید یا تغییر داده، فقط مسیر باقیماندهٔ ناوگان را در زمان کوتاه بهروزرسانی میکند.
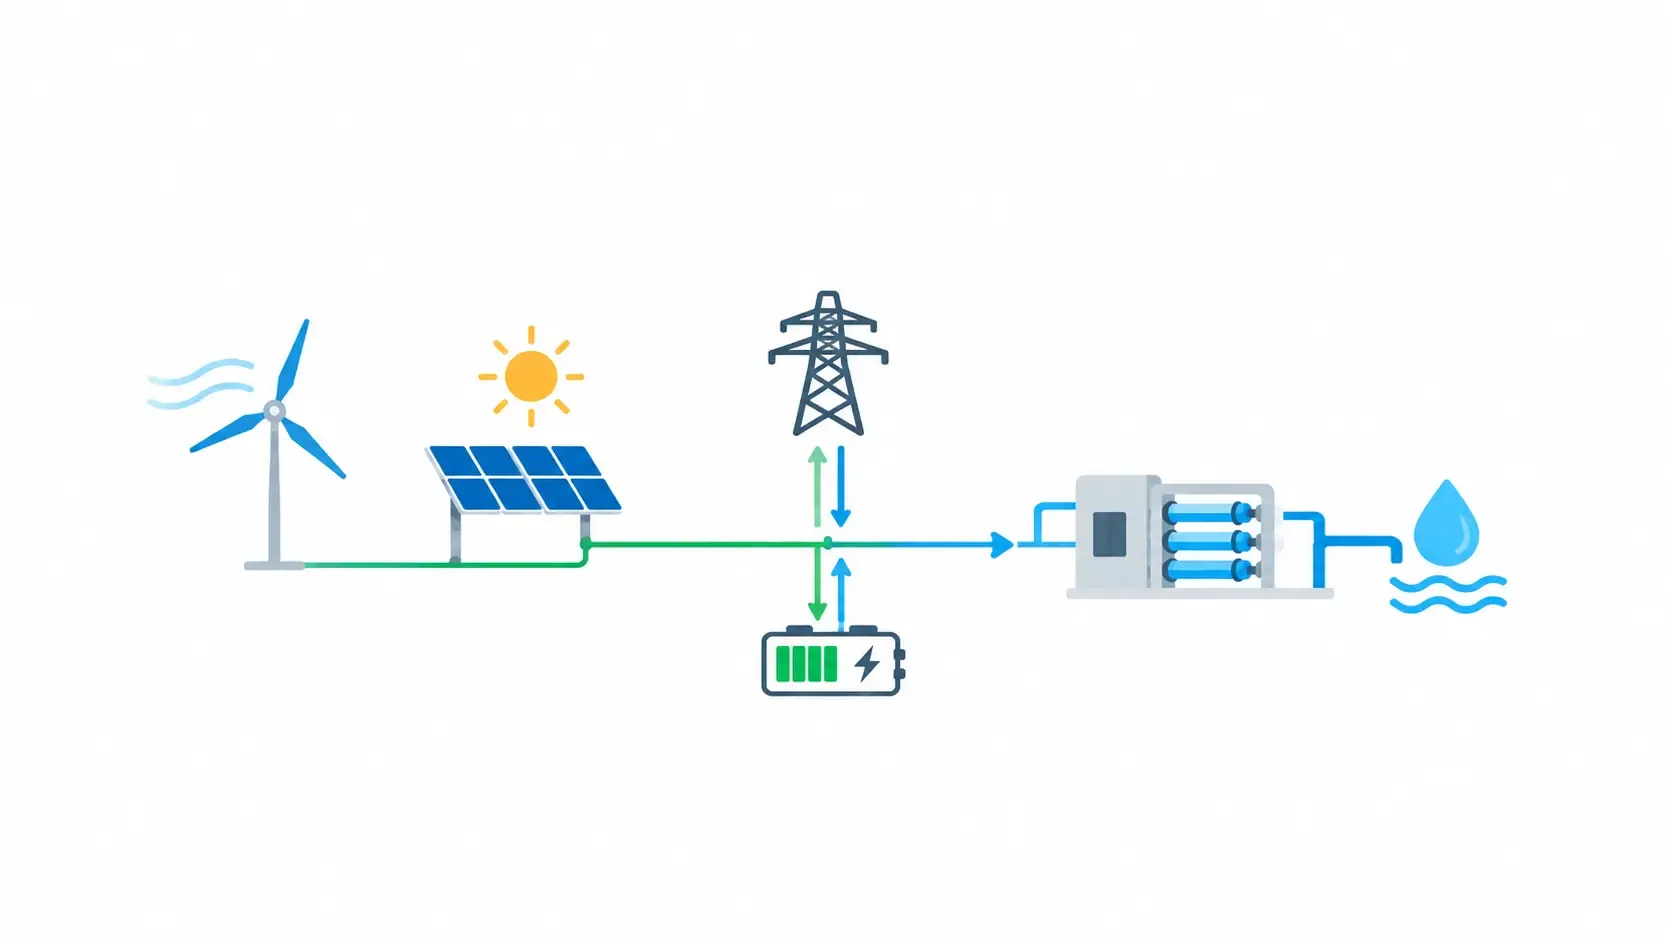
بهرهبرداری و طراحی بهینهی سیستم انرژی-آب یکپارچه
اندازهیابی تجهیزات و بهرهبرداری ساعتی یک سیستم یکپارچهٔ بادی، خورشیدی، باتری و آبشیرینکن در افق پنجساله، با هدف کاهش هزینه و انتشار کربن.