
مدل غیرقابلاجرا: چطور قید مقصر را پیدا کنیم؟
معرفی روشهای تشخیص هستهی تناقض در مدلهای بهینهسازی غیرقابلاجرا (Infeasible) و پیادهسازی آن با OR-Tools CP-SAT در پایتون.
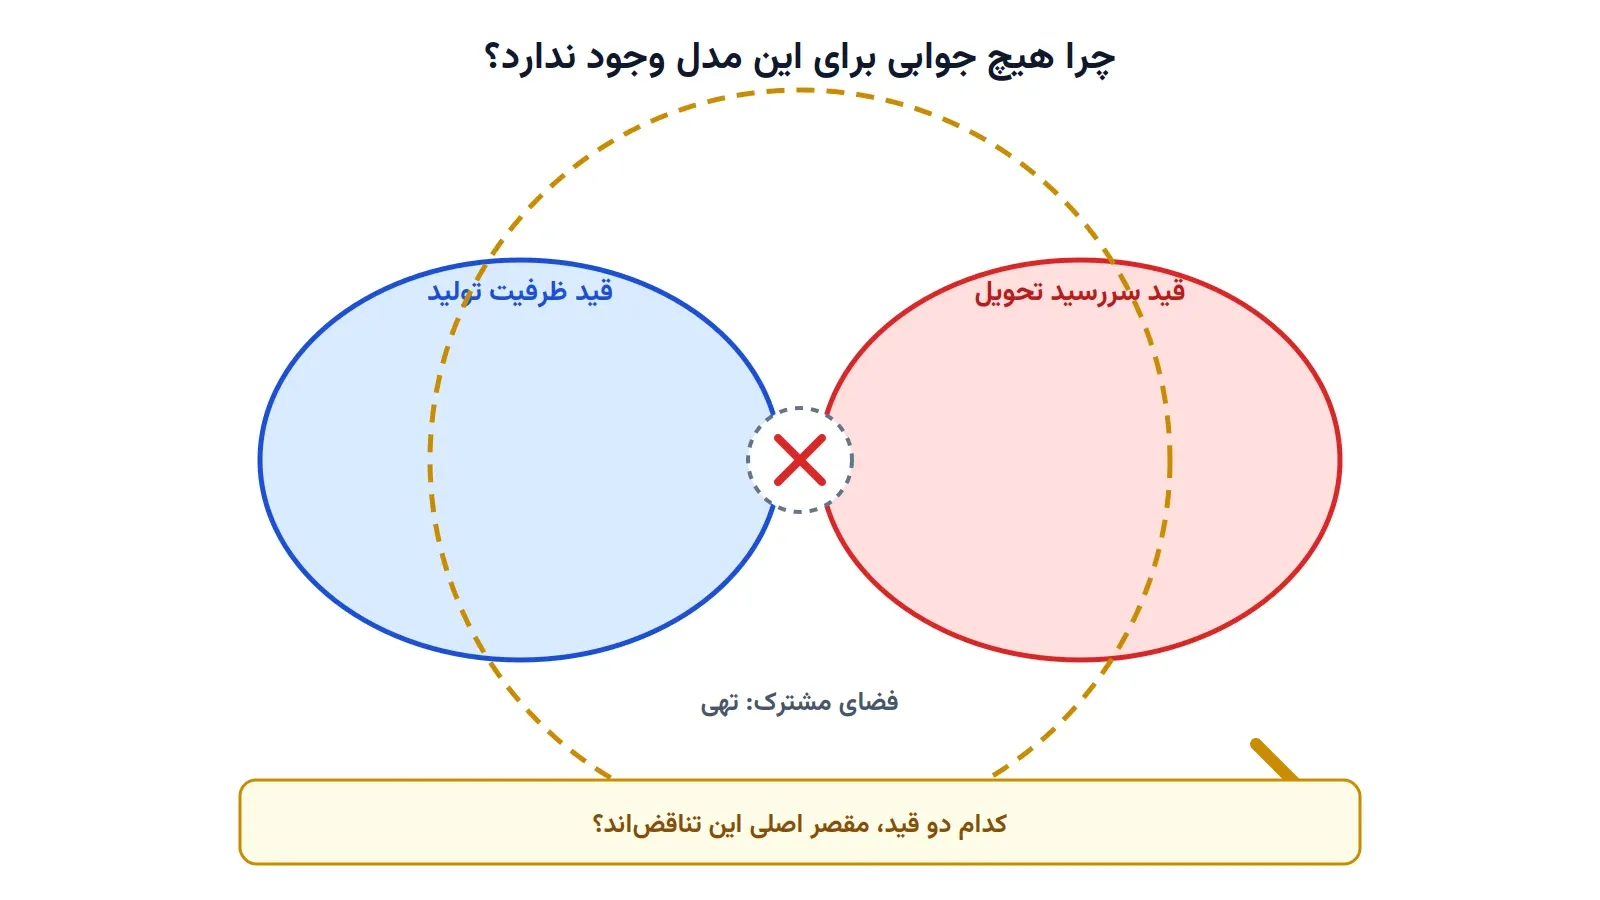
مدل زمانبندی تولیدتان را نوشتهاید؛ دهها قید، از ظرفیت خط تا سررسید تحویل. سالور را اجرا میکنید. بعد از چند دقیقه انتظار، یک کلمه تحویل میدهد: INFEASIBLE. حالا چه کار کنیم؟
۱. گریه کنیم؟ ۲. با همکاری که این مدل را نوشته تماس بگیریم؟ ۳. گوگل کنیم؟ ۴. از چتجیپیتی بپرسیم؟
هیچکدام. همین مطلب را بخوانید.
این تجربه برای هر کسی که با بهینهسازی کار کرده، آشناست. مدل بزرگ میشود، قیدها روی هم انباشته میشوند، و یک روز سالور میگوید جوابی وجود ندارد. سوال این نیست که «چرا جواب نداریم»؛ سوال این است که «کدام قید مقصر است». این مطلب دقیقاً همین سوال دوم را پاسخ میدهد.
تفاوت INFEASIBLE و UNKNOWN
قبل از هر چیز، باید بین دو وضعیت متفاوت سالور فرق گذاشت. وضعیت INFEASIBLE یعنی سالور رسماً ثابت کرده هیچ جوابی وجود ندارد. وضعیت UNKNOWN یعنی زمان تمام شده، بدون اثبات هیچچیز. این دو، مسئلهی کاملاً متفاوتی هستند.
اثبات غیرقابلاجرا بودن یک مدل بزرگ، خودش میتواند بهاندازهی پیدا کردن جواب بهینه سخت باشد. برای همین، مدلی که واقعاً هم ناشدنی است، گاهی فقط UNKNOWN برمیگرداند. راهحل این حالت، افزایش زمان یا سادهسازی مدل است؛ نه جستوجوی قید مقصر.
چند ترفند عملی برای وضعیت UNKNOWN
گاهی سالور برای اکثر نمونههای یک مسئله سریع است، اما روی یک نمونهی خاص گیر میکند. این الگو معمولاً نشانهی وجود یک بخش سخت درون همان نمونه است. مثلاً شاید فقط یک ترکیب خاص از پرسنل و شیفت، در یک بازهی زمانی کوچک، کل مدل را قفل کرده باشد.
یک ترفند مؤثر، تجزیهی افق زمانی به بازههای کوچکتر است؛ مثلاً هر چهار ساعت یک تکه. هر تکه را جدا حل کنید و زمان حل هرکدام را بسنجید. تکهای که بیشترین زمان میبرد، احتمالاً همان بخش مشکلدار است. میتوانید آن بخش را با یک جواب شناختهشده ثابت نگه دارید، یا یک راهنمای جزئی به سالور بدهید. راه دیگر این است که منابع بیشتری به همان بازه اختصاص دهید.
ترفند دوم، ساختن یک جواب اولیه با منطق انسانی است. همان قاعدههایی که یک برنامهریز باتجربه برای چیدن شیفتها بهکار میبرد، قابلپیادهسازی دستی است. این جواب، حتی اگر بهینه نباشد، بهعنوان راهنما به سالور داده میشود و جستوجو را سرعت میبخشد.
ترفند سوم، بازبینی دستی خودِ مدل روی یک نمونهی کوچک است. کل متغیرها و قیدهای مدل را برای یک نمونهی کوچک چاپ کنید و یکییکی مرور کنید. گاهی یک باگ ساده در کد باعث میشود قیدهای اضافی و بیدلیل به مدل اضافه شوند. این نوع خطا معمولاً فقط با مرور دستی یک نمونهی کوچک قابلکشف است.
چرا پیدا کردن قید مقصر بهصورت دستی سخت است؟
با تعداد کمی قید، میتوان یکییکی آنها را حذف کرد و دوباره حل کرد. اما با دهها یا صدها قید، این کار بهسرعت غیرعملی میشود. ترکیبهای ممکن برای حذف، بهصورت نمایی رشد میکند.
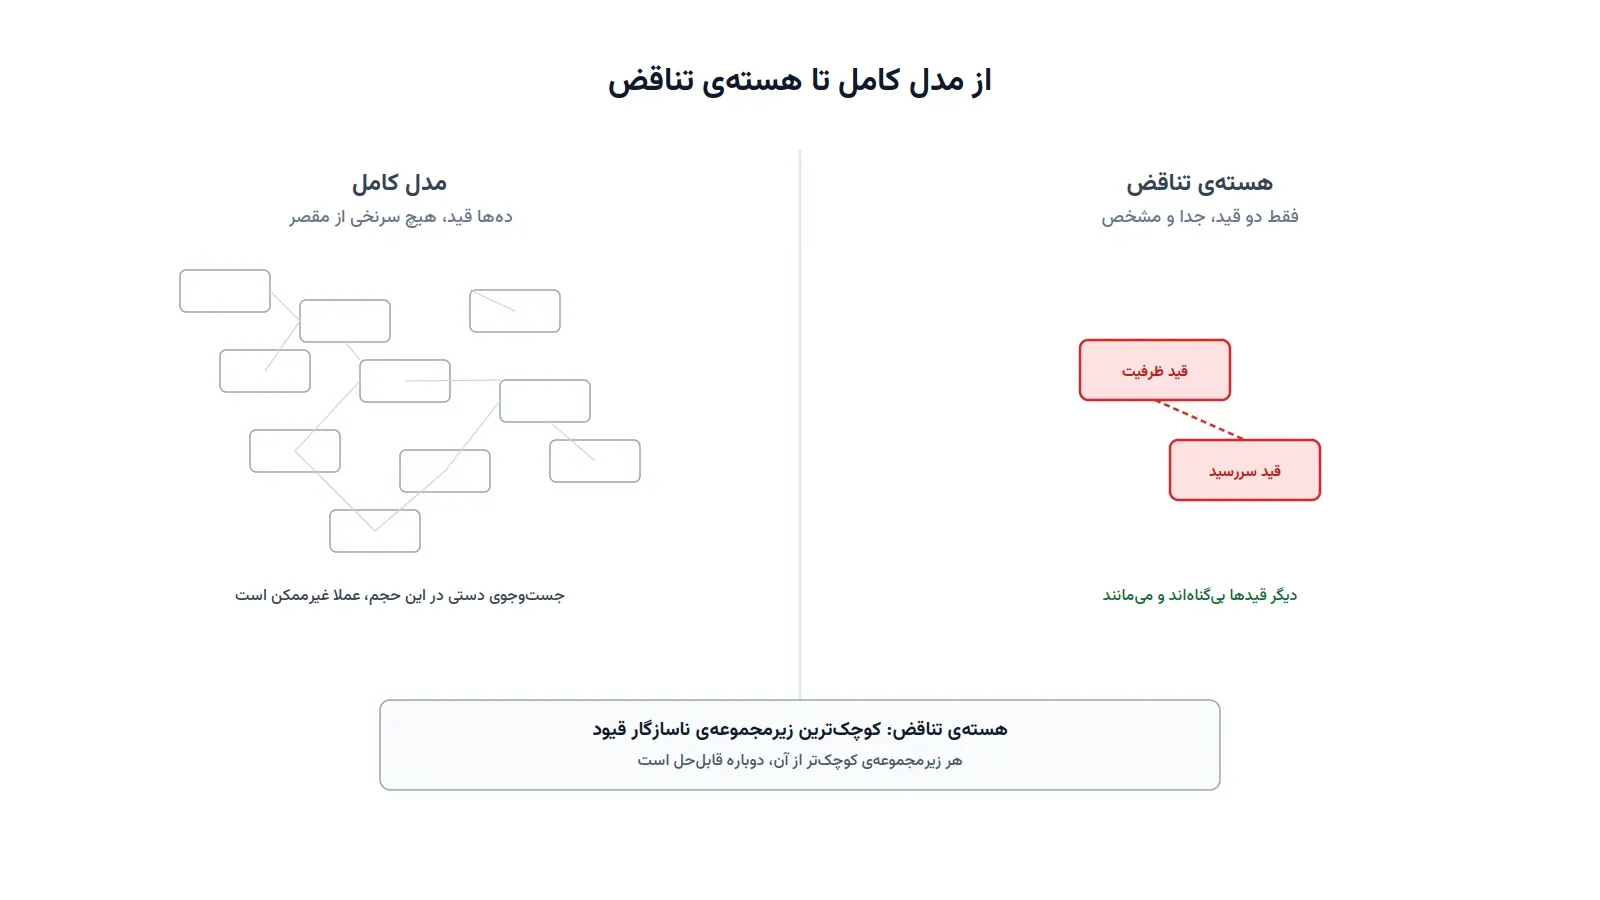
آنچه واقعاً لازم است، کوچکترین زیرمجموعهی قیودی است که با هم تناقض دارند. به این زیرمجموعه، هستهی تناقض یا Irreducible Infeasible Subset گفته میشود. اگر حتی یکی از قیدهای این هسته حذف شود، مدل دوباره شدنی میشود. بقیهی قیدها، در این تناقض بیگناهاند.
فرمولبندی مفهومی
فرض کنید مجموعهی قیدهای مدل را با نشان دهیم. برای هر قید ، یک متغیر باینری تعریف میکنیم که فعالبودن آن قید را کنترل میکند. هدف، یافتن کوچکترین زیرمجموعهای از این قیدهاست که بهتنهایی ناشدنی باشد:
هر زیرمجموعهی محض کوچکتر از باید شدنی بماند. این خاصیت مینیمالبودن است که هستهی تناقض را از یک لیست تصادفی قیدهای مشکوک متمایز میکند.
راهکار عملی: قیدهای فرضی
سالورهای برنامهریزی محدودیت مثل OR-Tools این ایده را بهصورت بومی پیادهسازی کردهاند. هر قید سخت، پشت یک متغیر باینری اختیاری قرار میگیرد. این متغیرها بهعنوان «قیدهای فرضی» یا Assumptions به سالور معرفی میشوند.
وقتی سالور جواب INFEASIBLE میدهد، یک متد جداگانه صدا زده میشود. این متد، همان زیرمجموعهی مینیمال قیدهای فرضی متناقض را برمیگرداند. دیگر نیازی به حذف دستی و آزمونوخطا نیست.
اهمیت این موضوع در دنیای واقعی
شرکتی مثل لوفتهانزا برای زمانبندی خدمهی پرواز، دهها قید همزمان دارد. ساعت مجاز کار، استراحت اجباری، و صلاحیت هر خلبان برای هر نوع هواپیما، همه باید همزمان رعایت شوند. وقتی تغییری در برنامهی پرواز، این قیدها را ناسازگار میکند، تیم برنامهریزی باید سریع بفهمد کدام قید مانع است.
بدون ابزار تشخیص هستهی تناقض، این جستوجو ساعتها زمان میبرد. تیم عملیاتی مجبور میشود قیدها را حدسی سست کند، بدون اطمینان از اینکه دلیل واقعی را پیدا کرده. این کار، هم زمان تلف میکند و هم اعتماد به مدل را کاهش میدهد.
مدلی که بتواند قید مقصر را دقیق نشان دهد، ارزش عملیاتی زیادی دارد. برنامهریز میتواند مستقیم سراغ همان قید برود؛ یا آن را با مدیر مربوطه مذاکره کند، یا سناریوی جایگزین بسازد. این دقیقاً تفاوت بین یک ابزار قابلاعتماد و یک جعبهی سیاه است.
ظرفیت کار آکادمیک و پژوهشی
استخراج هستهی تناقض، حوزهای فعال در پژوهش بهینهسازی و برنامهریزی محدودیت است. یک مسیر پژوهشی، مقایسهی الگوریتمهای استخراج است. روشهای حذفی ساده، روشهایی مثل QuickXplain، و روشهای مبتنیبر یادگیری تعارض، هرکدام کارایی متفاوتی دارند.
مسیر دوم، تمایز بین هستهی کمینه از نظر تعداد قید و هستهی کمینه از نظر هزینهی رفع تعارض است. گاهی یک هستهی دوقیدی وجود دارد که رفع آن گران است، در برابر هستهی سهقیدی که رفعش ارزانتر است. انتخاب میان این دو، خودش یک مسئلهی تصمیمگیری است.
مسیر سوم، کاربرد این تکنیک در سامانههای بلادرنگ است. وقتی یک سیستم زمانبندی باید در چند ثانیه دوباره برنامهریزی کند، سرعت استخراج هستهی تناقض اهمیت مستقیم عملیاتی پیدا میکند. مسیر چهارم هم مقایسهی این تکنیک بین برنامهریزی محدودیت و برنامهریزی عدد صحیح مختلط است.
پیادهسازی با پایتون
خبر خوب این است که این قابلیت در کتابخانهی متنباز OR-Tools و ماژول CP-SAT آن، بهصورت آماده وجود دارد. نیازی به هیچ سالور تجاری گرانقیمتی نیست. کد زیر یک مثال کوچک را نشان میدهد. سه کار روی یک ماشین اجرا میشوند و سررسید مشترک دارند. مجموع زمان این سه کار، از افق موجود بیشتر است.
from ortools.sat.python import cp_model

model = cp_model.CpModel()

jobs = ["J1", "J2", "J3"]
duration = {"J1": 4, "J2": 3, "J3": 5}
deadline = {"J1": 6, "J2": 6, "J3": 6}
big_horizon = 20

start = {j: model.NewIntVar(0, big_horizon, f"start_{j}") for j in jobs}
end = {j: model.NewIntVar(0, big_horizon, f"end_{j}") for j in jobs}
interval = {j: model.NewIntervalVar(start[j], duration[j], end[j], f"iv_{j}") for j in jobs}

model.AddNoOverlap(list(interval.values()))

assume = {}
for j in jobs:
    b = model.NewBoolVar(f"assume_deadline_{j}")
    model.Add(end[j] <= deadline[j]).OnlyEnforceIf(b)
    assume[j] = b

model.AddAssumptions(list(assume.values()))

solver = cp_model.CpSolver()
status = solver.Solve(model)
print("وضعیت:", solver.StatusName(status))

if status == cp_model.INFEASIBLE:
    core = solver.SufficientAssumptionsForInfeasibility()
    culprit_jobs = [j for j, b in assume.items() if b.Index() in core]
    print("قیدهای مقصر:", culprit_jobs)
اجرای این کد، وضعیت INFEASIBLE و دقیقاً دو کار را بهعنوان مقصر برمیگرداند؛ نه هر سه کار را. این یعنی سالور بهدرستی کوچکترین زیرمجموعهی ناسازگار را پیدا کرده. کار سوم، در این تناقض خاص، بیگناه است.
و اگر از Gurobi استفاده کنید؟
سالور تجاری Gurobi این قابلیت را حتی سادهتر پیاده کرده است. کافی است بعد از دریافت وضعیت INFEASIBLE، متد computeIIS را صدا بزنید. دیگر نیازی به تعریف دستی متغیرهای فرضی نیست؛ خود Gurobi هستهی تناقض را پیدا میکند.
import gurobipy as gp
from gurobipy import GRB

model = gp.Model("production")
x1 = model.addVar(name="x1")
x2 = model.addVar(name="x2")

model.addConstr(x1 + x2 <= 100, name="capacity")
model.addConstr(x1 >= 70, name="demand1")
model.addConstr(x2 >= 60, name="demand2")

model.optimize()

if model.status == GRB.INFEASIBLE:
    model.computeIIS()
    for c in model.getConstrs():
        if c.IISConstr:
            print("قید مقصر:", c.ConstrName)
در این مثال، ظرفیت تولید ۱۰۰ واحد است؛ اما مجموع دو تقاضا ۱۳۰ واحد است. اجرای کد نشان میدهد هر سه قید واقعاً مقصرند. حذف هرکدام از این سه، مدل را دوباره شدنی میکند. Gurobi همچنین امکان ذخیرهی این هسته در یک فایل جداگانه، با دستور model.write("model.ilp")، را هم میدهد.
استفاده از Gurobi نیازمند لایسنس است، هرچند نسخهی رایگان برای دانشگاهیان و مدلهای کوچک هم در دسترس است. برای مدلهای عدد صحیح مختلط با ابزارهای کاملاً متنباز مثل PuLP یا Pyomo، این ایدهی قیدهای فرضی را میتوان با متغیرهای شرطی دستی، روی سالورهایی مثل HiGHS هم بازسازی کرد. دوره مدلسازی و بهینهسازی ریاضی دقیقاً همین نوع تکنیکهای مدلسازی پیشرفته را آموزش میدهد.
اما شاید اصلاً لازم نباشد
با همهی این ابزارها، یک روش سادهتر هم هست که نباید فراموش شود. وقتی مدل را مینویسید، قید به قید اضافه کنید؛ نه همه را یکجا. بعد از هر قید تازه، مدل را دوباره حل کنید.
همان لحظهای که مدل از شدنی به ناشدنی تغییر حالت میدهد، مقصر پیدا شده. این سادهترین و مطمئنترین راه تشخیص است؛ چون خودتان لحظهی دقیق شکست را دیدهاید.
ابزارهای آماده، مثل هستهی تناقض یا Assumptions، جای این عادت را نمیگیرند. آنها برای مدلهای بزرگ و پیچیده به کار میآیند، جایی که ساخت تدریجی دیگر عملی نیست. اما برای بیشتر پروژهها، همین عادت ساده کافی است. خودتان را برای مسائل کوچکتر، خستهی ابزارهای پیچیده نکنید.
سوالات متداول
اگر سالور بهجای INFEASIBLE، وضعیت UNKNOWN برگرداند، باید چه کار کرد؟
ابتدا باید زمان حل را افزایش داد یا مدل را ساده کرد. تکنیک هستهی تناقض فقط زمانی معنا دارد که سالور واقعاً اثبات کرده باشد مدل ناشدنی است.
یادگیری مدلسازی پیشرفته و تکنیکهای عیبیابی مدل از کجا ممکن است؟
دوره مدلسازی و بهینهسازی ریاضی اصول ساخت، اعتبارسنجی و عیبیابی مدلهای بهینهسازی را با ابزارهای متنباز پوشش میدهد.
آیا میتوان این روش را روی مدل واقعی و بزرگ خودمان پیاده کرد؟
بله؛ ساختار قیدها و اندازهی مدل در هر پروژه متفاوت است. بهتر است روش عیبیابی متناسب با همان مدل طراحی شود. از طریق مشاوره میتوانید جزئیات پروژه را مطرح کنید.
مشاوره و ارتباط با ما
برای مشاوره و ثبتنام در دورهها و دریافت پروژهها با آیدی @pypyid در تلگرام در تماس باشید.
مطالب پیشنهادی
دورههای آموزشی مرتبط
دوره مدلسازی مسائل بهینهسازی
یاد بگیرید مسائل واقعی را به مدل ریاضی تبدیل کنید: متغیر تصمیم، تابع هدف، قیود و ساخت مدلهای LP، MILP و NLP با مثالهای کاربردی.
دوره جامع بهینهسازی سیستمهای سلامت با پایتون
دوره جامع و پروژهمحور بهینهسازی در حوزه سلامت و درمان با Python و OR-Tools؛ ۲۰ پروژه عملی از تخصیص تخت بیمارستان تا امداد پهپادی به مناطق آسیبدیده.
آموزش مسیریابی وسایل نقلیه (VRP) با پایتون و OR-Tools
دوره پروژهمحور VRP در پایتون با OR-Tools و CP-SAT؛ ۲۰ پروژه عملی از TSP و CVRP تا VRPTW و مسیریابی خودروی الکتریکی.
دوره فشرده مدلسازی عدم قطعیت در بهینهسازی
دوره فشرده مدلسازی عدم قطعیت: مقایسه روشهای Stochastic، Fuzzy، Robust و IGDT با کاربرد در انرژی و سیستم قدرت.
مقالات و یادداشتهای مرتبط
حل همه جوابها با OR-Tools
آموزش پیدا کردن همه جوابهای یک مدل با Constraint Programming در OR-Tools؛ همراه با یک مثال ساده و قابل اجرا در Python برای درک enumerate کردن جوابها.
سه روش عملی استفاده از Solverها در Pyomo
سه روش عملی برای نصب و استفاده از Solverهای رایگان در Pyomo؛ اجرای محلی، کار با Google Colab و استفاده از سرویس NEOS برای حل مدلهای بهینهسازی.
مکانیابی ایستگاه آمبولانس با پایتون
آشنایی با مسئله مکانیابی پوششی حداکثری (Maximum Covering Location Problem) برای استقرار آمبولانس و ایستگاههای اورژانس، و حل آن با ابزارهای متنباز پایتون.
تخصیص اسکله بندر: کدام کشتی، کجا و کِی پهلو بگیرد؟
مسئله تخصیص اسکله (Berth Allocation Problem) و مدلسازی ریاضی آن برای کاهش زمان انتظار کشتیها در بنادر با ابزارهای متنباز پایتون.
پروژههای مرتبط
جایابی باتری برای کاهش هدررفت تجدیدپذیرها
جایابی بهینه ایستگاههای ذخیرهسازی انرژی در شبکه انتقال برای کاهش هدررفت تولیدات تجدیدپذیر و بهبود بهرهبرداری با استفاده از مدلسازی ریاضی.
مدیریت هوشمند انرژی شهرک مسکونی با پنل خورشیدی، باتری و خودروی الکتریکی (V2G)
تعیین برنامهی بهینهی دیسپچ متمرکز پنل خورشیدی، باتری خانگی، باتری مشترک شهرکی و شارژ/دشارژ دوطرفهی خودروی الکتریکی (V2G) در یک شهرک ۷۵ خانهای، با مدلسازی ریاضی مشترک و محدودیت واقعی ظرفیت فیدر، با نگاه به کاهش هزینه و کاهش پیک تقاضای شبکه.
بازبرنامهریزی پویای مسیر: سیستم مسیریابی زمانواقعی برای سفارشهای جدید
طراحی و پیادهسازی یک سیستم مسیریابی پویای وسایل نقلیه (Dynamic VRP) که با رسیدن سفارش جدید یا تغییر داده، فقط مسیر باقیمانده ناوگان را در زمان کوتاه بهروزرسانی میکند.
بهرهبرداری و طراحی بهینهی سیستم انرژی-آب یکپارچه
تعیین اندازهی بهینهی تجهیزات و برنامهی بهرهبرداری ساعتی یک سیستم یکپارچهی بادی، خورشیدی، باتری، شبکه، و آبشیرینکن با افق پنجساله، با استفاده از مدلسازی ریاضی مشترک سایزینگ و عملیات و با نگاه به کاهش اثرات زیستمحیطی و انتشار کربن.