
نوبتدهی درمانگاه سرپایی: مدل ریاضی رزرو هوشمند
چطور با مدل بهینهسازی و سالور CP-SAT، نوبتدهی درمانگاه سرپایی را طوری طراحی کنیم که هم عدمحضور بیماران جبران شود و هم انتظار کم بماند.
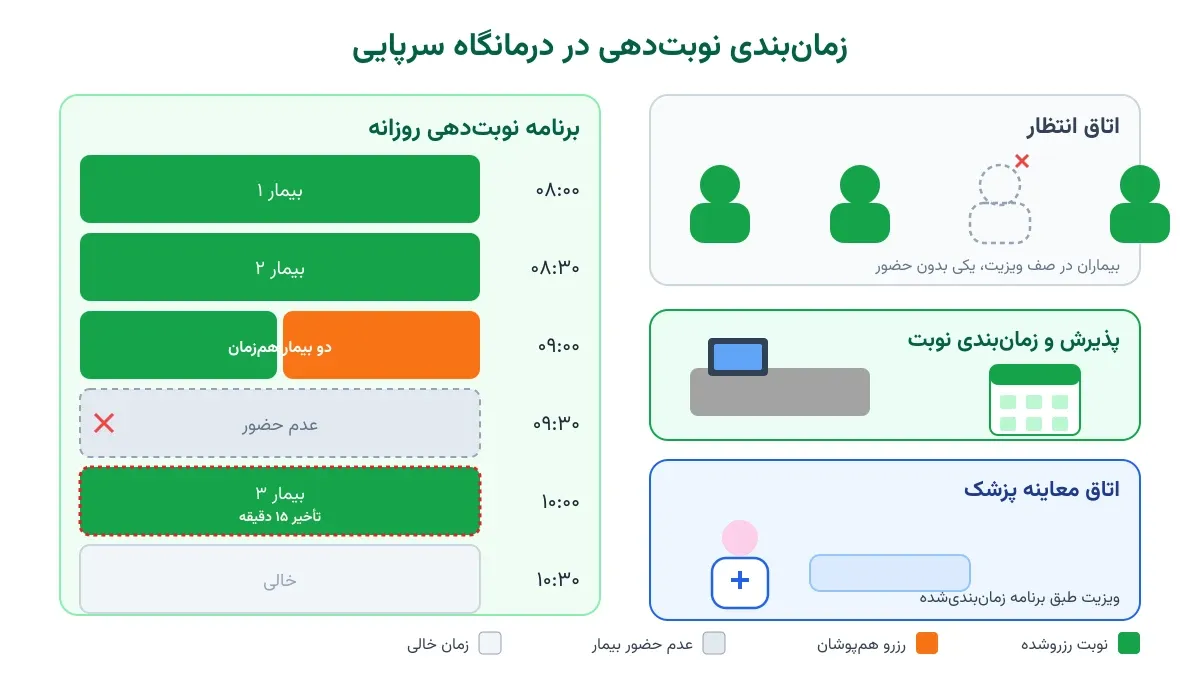
هر درمانگاه سرپایی هر روز با یک معمای یکسان روبهرو است. باید برای دهها بیمار نوبت تعیین کند، بدون اینکه از قبل بداند کدامیک واقعاً سر وقت میآیند. این یادداشت نشان میدهد چطور میتوان این معما را با یک مدل بهینهسازی دقیق حل کرد. راهحل، حدس و تجربه شخصی منشی پذیرش نیست.
چرا زمانبندی نوبتدهی سرپایی اینقدر دشوار است؟
روی کاغذ، نوبتدهی ساده به نظر میرسد: هر بیمار یک بازه زمانی میگیرد و پزشک یکییکی ویزیت میکند. اما در عمل، چند عامل این مسئله را پیچیده میکنند.
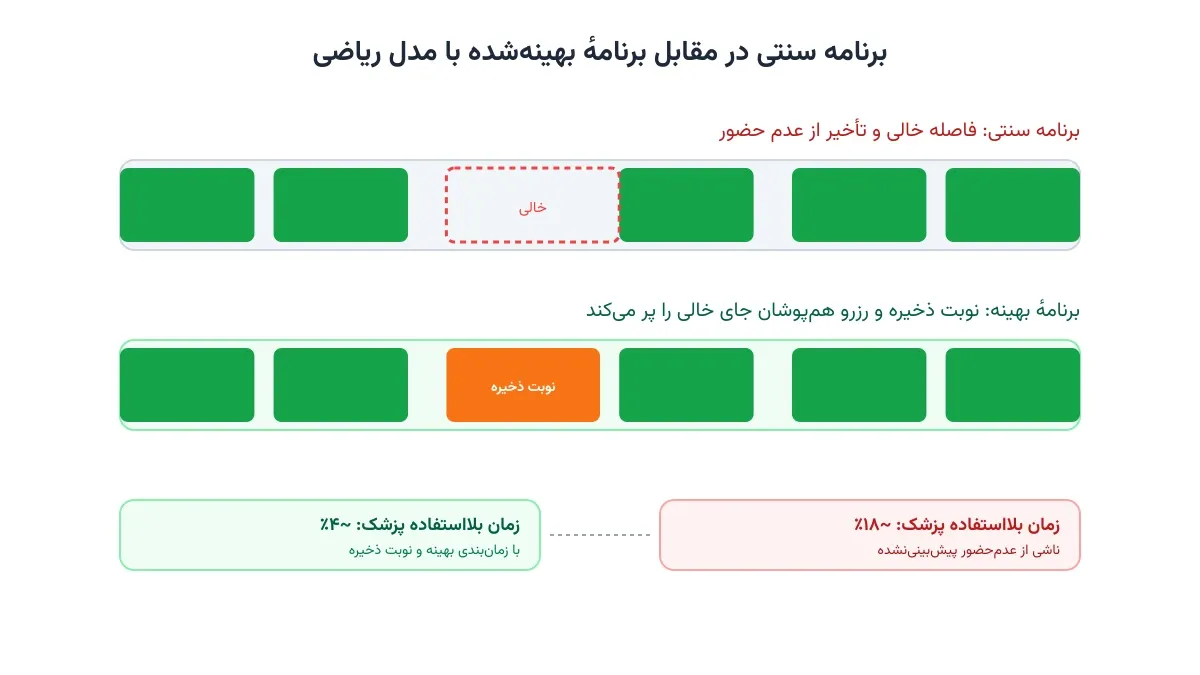
نرخ عدمحضور بیماران (No-show Rate) در بسیاری از درمانگاهها بین ۱۰ تا ۳۰ درصد است. اگر برای هر بیمار دقیقاً یک نوبت خالی نگه دارید، این درصد از وقت پزشک بیاستفاده میماند. اگر برای جبران آن نوبتهای همزمان رزرو کنید (Overbooking)، وقتی همه بیماران سر وقت بیایند، زمان انتظار بهشدت بالا میرود.
طول هر ویزیت هم ثابت نیست. یک معاینه ساده شاید ده دقیقه طول بکشد، اما ویزیت بیمار مزمن با چند سؤال، میتواند نیم ساعت وقت بگیرد. مدلی که طول ویزیت را ثابت فرض کند، همیشه یا وقت پزشک را هدر میدهد. یا باعث تأخیر زنجیرهای در کل روز میشود.
مدل ریاضی مسئله نوبتدهی
برای حل این مسئله، ابتدا باید آن را به زبان دقیق ریاضی ترجمه کنیم. فرض کنید بیمار باید در طول یک روز کاری با بازه زمانی ویزیت شوند.
متغیرهای تصمیم
متغیر دودویی برابر یک است اگر بیمار به بازه زمانی تخصیص یابد، و در غیر این صورت صفر است. متغیر کمکی هم نشان میدهد آیا بازه بهصورت همپوشان (بیش از یک بیمار) رزرو شده یا نه.
تابع هدف
هدف، کمینهکردن مجموع وزنی زمان انتظار بیماران و زمان بیکاری پزشک است:
وزنهای و نشان میدهند درمانگاه به کدام هدف اهمیت بیشتری میدهد: رضایت بیمار یا بهرهوری پزشک.
قیدهای اصلی
هر بیمار باید دقیقاً به یک بازه تخصیص یابد:
ظرفیت هر بازه محدود است، اما برای بازههای پرخطر (با احتمال بالای عدمحضور) میتوان سقف را به دو رساند:
قید دیگر، ترتیب زمانی است: مجموع طول ویزیتهای تخصیصیافته به هر بازه، نباید از طول آن بازه بیشتر شود. این دقیقاً جایی است که احتمال عدمحضور هر بیمار، بهصورت یک پارامتر تصادفی وارد مدل میشود. همین نکته، مسئله را به یک بهینهسازی تصادفی تبدیل میکند.
اهمیت این موضوع
نوبتدهی بهینه، فقط یک مسئله ریاضی انتزاعی نیست؛ مستقیماً روی درآمد و کیفیت درمان اثر میگذارد. شبکههای بزرگ درمانی مثل کایزر پرمننته، سالهاست روی مدلهای پیشبینی عدمحضور و زمانبندی هوشمند سرمایهگذاری میکنند. هدف این سرمایهگذاری، کوتاهنگهداشتن صف انتظار و جلوگیری از هدررفت ظرفیت پزشکان است.
وقتی زمان پزشک هدر برود، هزینه فرصت آن مستقیماً به بیمار بعدی یا به کل سیستم سلامت منتقل میشود. از طرف دیگر، صف طولانی باعث نارضایتی بیمار و حتی ترک درمان میشود. مدل بهینهسازی، این دو هدف متضاد را بهطور همزمان در نظر میگیرد؛ کاری که با روشهای دستی و تجربهمحور عملاً ممکن نیست. برای آشنایی با مسئله مشابه در بخش دیگری از بیمارستان، یادداشت زمانبندی صندلی دیالیز را هم ببینید.
ظرفیت کار آکادمیک و پژوهشی
این مسئله یکی از فعالترین حوزههای پژوهش در مدیریت عملیات سلامت (Healthcare Operations Management) است. چند مسیر پژوهشی باز در این زمینه وجود دارد.
مدلسازی تصادفی دومرحلهای (Two-stage Stochastic Programming) یکی از رویکردهای رایج است. مرحله اول، تخصیص اولیه نوبتها را تعیین میکند. مرحله دوم هم واکنش به عدمحضورهای واقعی را مدل میکند. موضوع دیگر، یادگیری آنلاین نرخ عدمحضور هر بیمار بر اساس سابقه اوست، نه یک نرخ ثابت و یکسان برای همه. ترکیب این دو رویکرد، یعنی تخمین پویای ریسک عدمحضور بههمراه بهینهسازی تصادفی، هنوز جای کار پژوهشی زیادی دارد. این فرصت پژوهشی وقتی چند پزشک و چند نوع ویزیت همزمان در نظر گرفته شوند، بزرگتر هم میشود.
پیادهسازی با پایتون
خبر خوب این است که برای حل این مسئله، نیازی به نرمافزار گرانقیمت تجاری نیست. کتابخانه متنباز OR-Tools گوگل، بهخصوص سالور CP-SAT آن، برای این نوع مسائل ترکیبیاتی گسسته بسیار مناسب است.
ورودی مدل، یک فهرست از بیماران با طول ویزیت تخمینی و احتمال عدمحضور هر کدام است. این فهرست معمولاً از یک فایل اکسل یا CSV خوانده میشود. اسکلت اولیه مدل در CP-SAT به این شکل است:
from ortools.sat.python import cp_model
model = cp_model.CpModel()
num_patients = len(patients)
num_slots = len(slots)
# متغیر تخصیص: آیا بیمار p به بازه s میرود؟
x = {}
for p in range(num_patients):
for s in range(num_slots):
x[p, s] = model.NewBoolVar(f"x_{p}_{s}")
# هر بیمار دقیقاً یک بازه میگیرد
for p in range(num_patients):
model.Add(sum(x[p, s] for s in range(num_slots)) == 1)
# ظرفیت هر بازه (با احتساب رزرو همپوشان در بازههای پرخطر)
for s in range(num_slots):
model.Add(sum(x[p, s] for p in range(num_patients)) <= slot_capacity[s])ادامه قیود زمانی و تابع هدف وزنی به همین شیوه تعریف میشوند. برای مسائل بزرگتر با چند پزشک و چند اتاق معاینه، ساختار شبکه هم به کار میآید. کتابخانه NetworkX برای مدلسازی جریان بیماران در این ساختار مناسب است.
سوالات متداول
بهترین نرخ overbooking برای یک درمانگاه چقدر است؟
عدد ثابتی وجود ندارد. این نرخ باید از داده تاریخی همان درمانگاه و احتمال عدمحضور واقعی بیماران آن به دست آید، نه یک قاعده سرانگشتی عمومی.
آیا این مدل فقط برای درمانگاههای بزرگ کاربرد دارد؟
خیر. حتی یک مطب کوچک با یک پزشک هم میتواند از نسخه سادهشده همین مدل برای کاهش زمان انتظار بیماران بهره ببرد. دوره بهینهسازی و تصمیمگیری سیستم سلامت با پایتون این موضوع را با مثالهای عملی پوشش میدهد.
برای پیادهسازی اختصاصی این مدل در درمانگاه خودم چه کار کنم؟
چون دادهها و قیود هر درمانگاه با دیگری فرق دارد، بهتر است مدل را متناسب با شرایط واقعی تنظیم کنید. برای این کار میتوانید درخواست مشاوره ثبت کنید.
مشاوره و ارتباط با ما
برای مشاوره و ثبتنام در دورهها و دریافت پروژهها با آیدی @pypyid در تلگرام در تماس باشید.
مطالب پیشنهادی
دورههای آموزشی مرتبط
دوره جامع بهینهسازی و تصمیمگیری سیستم سلامت با پایتون
دوره جامع و پروژه محور بهینهسازی و تصمیمگیری سیستم سلامت با پایتون و OR-Tools؛ ۲۰ پروژه عملی از تخصیص تخت بیمارستان تا امداد پهپادی به مناطق آسیبدیده.
آموزش مسیریابی وسایل نقلیه (VRP) با پایتون و OR-Tools
دوره پروژهمحور VRP در پایتون با OR-Tools و CP-SAT؛ ۲۰ پروژه عملی از TSP و CVRP تا VRPTW و مسیریابی خودروی الکتریکی.
دوره فشرده مدلسازی عدم قطعیت در بهینهسازی
دوره فشرده مدلسازی عدم قطعیت: مقایسه روشهای Stochastic، Fuzzy، Robust و IGDT با کاربرد در انرژی و سیستم قدرت.
آموزش مقدماتی بهینهسازی سیستمهای قدرت
شروع بهینهسازی سیستمهای قدرت در ۸ ساعت با پایتون: پخش بار اقتصادی، DC-OPF، مدلسازی باتری و مقدمه Unit Commitment؛ مناسب دانشجویان و پژوهشگران برق.
مقالات و یادداشتهای مرتبط
زمانبندی صندلی دیالیز: هماهنگی هفتگی برای بیماران مزمن
چگونه بهینهسازی میتواند صندلیها، دستگاهها و پرستاران مراکز همودیالیز را برای بیمارانی که هفتهای سه بار نیاز به درمان دارند، به بهترین شکل زمانبندی کند.
اعزام آمبولانس: کدام پایگاه، به کدام حادثه، در کمترین زمان؟
چگونه بهینهسازی و مدلهای پوشش احتمالاتی به تصمیم مکانیابی پایگاه و اعزام آمبولانس در شرایط عدمقطعیت تقاضا کمک میکنند.
مکانیابی ایستگاه آمبولانس با پایتون
آشنایی با مسئله مکانیابی پوششی حداکثری (Maximum Covering Location Problem) برای استقرار آمبولانس و ایستگاههای اورژانس، و حل آن با ابزارهای متنباز پایتون.
جابهجایی پویای آمبولانس: کجا منتظر بمانیم تا زودتر برسیم؟
آشنایی با مسئله مکانیابی و جابهجایی پویای آمبولانس در خدمات اورژانس پزشکی، و مدلسازی آن با ابزارهای متنباز پایتون.
پروژههای مرتبط
زمانبندی بازرسی قصابیها با OR-Tools
مدلسازی و حل مسئله زمانبندی بازرسی قصابیها با OR-Tools در پایتون؛ یک مثال عملی از Task Scheduling و تخصیص بهینه بازرسها.
مسیریابی پویا (Dynamic VRP): بازبرنامهریزی زمانواقعی
سیستم مسیریابی پویا (Dynamic VRP) که با رسیدن سفارش جدید یا تغییر داده، فقط مسیر باقیماندهٔ ناوگان را در زمان کوتاه بهروزرسانی میکند.
بهینهسازی استخدام و آموزش: تکمیل تیم با بودجه و زمان محدود
تخصیص نامزدها به موقعیتهای شغلی و زمانبندی آموزش برای رفع کمبود مهارت، در چارچوب بودجهٔ استخدام، بودجهٔ آموزش و مهلت آمادهبهکار شدن.
زمانبندی شیفت پزشکان بیمارستان: پوشش، استراحت و عدالت
زمانبندی شیفت پزشکان و دستیاران با پوشش کامل هر شیفت، استراحت پس از شبکاری، سقف روزهای کاری، عدالت در شیفت شب و تداوم مراقبت.