
طراحی زنجیره تأمین دومرحلهای زیر عدمقطعیت تقاضا
مدلسازی برنامهریزی تصادفی دومرحلهای برای طراحی شبکه زنجیره تأمین زیر عدمقطعیت تقاضا، با فرمولبندی MILP و پیادهسازی کامل در پایتون با Pyomo.
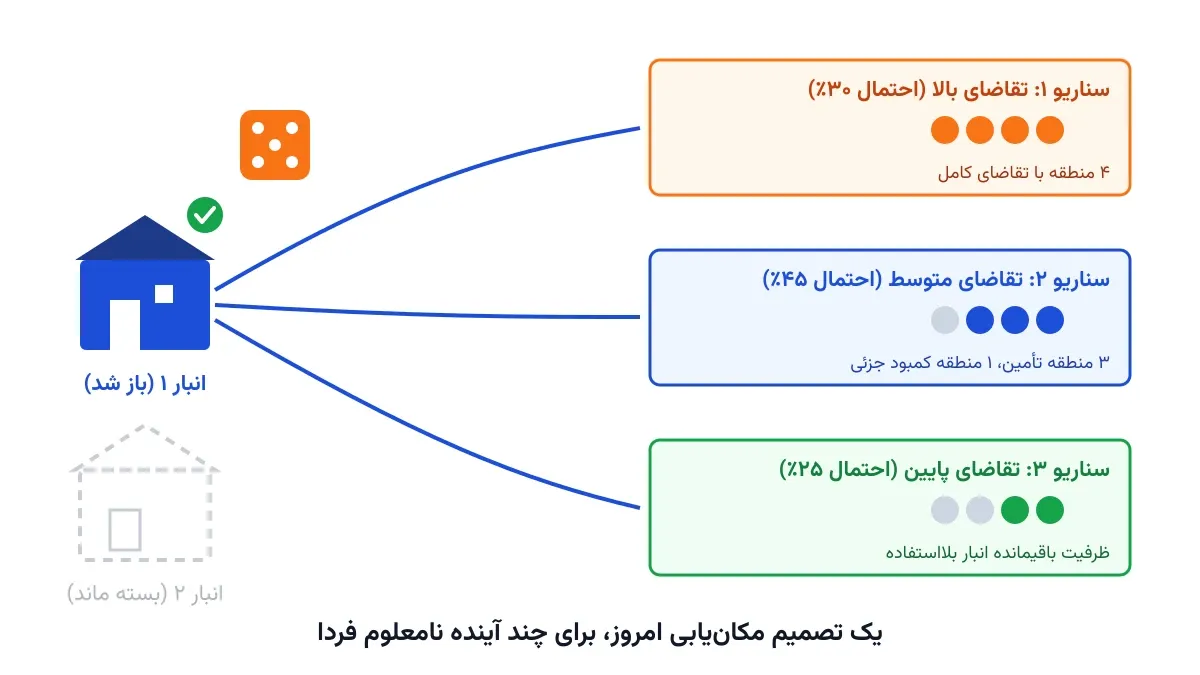
فرض کنید باید همین امروز تصمیم بگیرید چند انبار جدید کجا ساخته شود. این تصمیم گران است و سالها پابرجا میماند. اما تقاضای واقعی مشتریان را فقط در آینده میفهمید. اگر انبار را در جای اشتباه بسازید، هزینهاش سالها روی دوش شرکت میماند. برنامهریزی تصادفی دومرحلهای (Two-Stage Stochastic Programming) دقیقاً برای همین معما طراحی شده است.
در مدلهای کلاسیک طراحی شبکه، معمولاً یک پیشبینی واحد از تقاضا در نظر میگیریم. اما تقاضای واقعی به رکود اقتصادی، تغییر ذائقه مشتری یا حرکت رقبا بستگی دارد. اگر یادداشت مسئله مکانیابی تسهیلات را خوانده باشید، آنجا تقاضا از قبل دقیقاً معلوم فرض شده بود. این یادداشت دقیقاً همان فرض ساده را کنار میگذارد و چند سناریوی ممکن تقاضا را همزمان در یک مدل میبیند.
اهمیت این موضوع
شرکتی مثل پیاندجی (P&G) در بازطراحی شبکه توزیع آمریکای شمالی خود دقیقاً با همین چالش روبهرو بوده است. باید مشخص میشد کدام کارخانهها و انبارها نگه داشته شوند، درحالیکه تقاضای آینده هر منطقه نامعلوم بود. چنین پروژههای بازطراحی شبکه، معمولاً برای یک دهه یا بیشتر ثابت میمانند. تصمیم اشتباه در چنین افقی، هزینهای میلیوندلاری در پی دارد.
اگر شرکت فقط بر مبنای خوشبینانهترین سناریو تصمیم بگیرد، در سناریوهای بد ظرفیت کم میآورد. اگر فقط بدبینانهترین حالت را در نظر بگیرد، در سناریوهای خوب هزینه اضافی پرداخته. صنایع خردهفروشی، لوازم خانگی و محصولات فصلی هم دقیقاً با همین معمای تقاضای نامعلوم روبهرو هستند. راهحل درست، دیدن همه سناریوهای محتمل همزمان در یک مدل واحد است، نه انتخاب یکی از دو حالت افراطی.
فرمولبندی ریاضی مسئله
مجموعه مکانهای کاندید برای احداث انبار را با نشان میدهیم و مجموعه مناطق مشتری را با . هزینه ثابت احداث انبار برابر است و ظرفیت آن . چون تقاضای آینده نامعلوم است، سناریوی ممکن را با احتمال در نظر میگیریم. تقاضای منطقه در سناریوی را با نشان میدهیم.
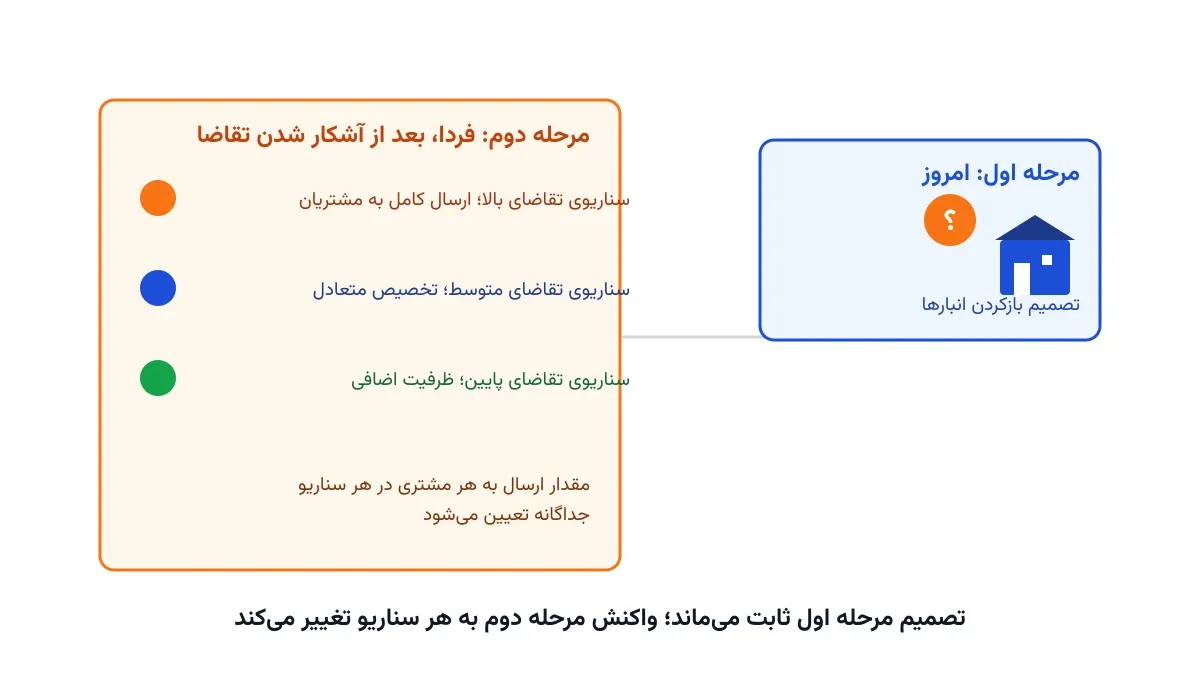
متغیر یک متغیر دودویی مرحله اول است؛ یعنی همین امروز، پیش از آشکار شدن تقاضا، تعیین میشود. متغیر مقدار ارسالی از انبار به منطقه در سناریوی است. این متغیر مرحله دوم، بعد از آشکار شدن تقاضا در هر سناریو تعیین میشود. متغیر هم کمبود تأمیننشده منطقه در سناریوی را نشان میدهد، با هزینه جریمه به ازای هر واحد.
با محدودیتهای زیر، برای هر منطقه و هر سناریوی :
جمله اول تابع هدف، هزینه ثابت شبکه است که فقط یکبار و مستقل از سناریو پرداخت میشود. جمله دوم، میانگین وزنی هزینه حملونقل و جریمه کمبود در تمام سناریوهاست. دقیقاً همین جمله دوم است که مدل را «تصادفی» میکند؛ مدل قطعی فقط یک سناریو را میبیند، نه میانگین وزنی همه آنها. محدودیت اول تضمین میکند تقاضای هر منطقه یا تأمین شود یا بهعنوان کمبود ثبت شود. محدودیت دوم میگوید فقط انبارهای بازشده میتوانند کالا ارسال کنند، و آن هم تا سقف ظرفیتشان.
این مدل را معمولاً «فرم گسترده» یا «معادل قطعی» مسئله تصادفی مینامند، چون همه سناریوها در یک مدل بزرگ ادغام شدهاند. برای چند ده سناریو، سالورهای MILP معمولی این فرم گسترده را مستقیم حل میکنند. اگر مفهوم مدلسازی عدمقطعیت برایتان تازه است، دوره مدلسازی عدمقطعیت پایه نظری لازم را بهطور کامل پوشش میدهد.
ظرفیت کار آکادمیک و پژوهشی
وقتی تعداد سناریوها به هزاران برسد، فرم گسترده مدل بسیار بزرگ و کند میشود. روش کلاسیک مقابله با این مشکل، تجزیه بندرز (Benders Decomposition) است. در ادبیات برنامهریزی تصادفی به آن روش ال-شکل (L-Shaped Method) هم میگویند. این روش مسئله را به یک مسئله اصلی برای تصمیم مرحله اول و چند زیرمسئله مستقل برای هر سناریو میشکند.
مسیر پژوهشی دیگر، کاهش سناریو (Scenario Reduction) است. یعنی انتخاب زیرمجموعهای کوچکتر و نماینده از سناریوهای اصلی، بدون افت کیفیت جواب. مسیر سوم، نسخه ریسکگریز مدل است. بهجای مینیممکردن میانگین هزینه، میتوان معیار CVaR را مینیمم کرد تا از بدترین سناریوها هم محافظت شود. مقایسه این رویکرد با بهینهسازی استوار (Robust Optimization)، که اصلاً به توزیع احتمال سناریوها نیاز ندارد، خودش یک حوزه پژوهشی فعال است.
پیادهسازی با پایتون
خبر خوب این است که حل این مدل نیازی به سالور تجاری گرانقیمت ندارد. کتابخانه متنباز Pyomo برای تعریف مجموعهها، پارامترها و متغیرهای اندیسدار روی سناریوها بسیار مناسب است. سالور رایگان HiGHS برای حل فرم گسترده مدل کفایت میکند؛ برای مسائل بزرگتر، CBC هم گزینه خوبی است.
داده ورودی این مسئله، شامل مختصات انبارهای کاندید، ظرفیت و هزینه ثابت هرکدام، و تقاضای هر منطقه در هر سناریو است. این داده را میتوان در چند برگه اکسل ساده نگه داشت و با pandas خواند. اسکلت اولیه مدل در Pyomo به این شکل شروع میشود:
import pyomo.environ as pyo
model = pyo.ConcreteModel()
model.J = pyo.Set(initialize=["DC1", "DC2", "DC3"]) # انبارهای کاندید
model.I = pyo.Set(initialize=["R1", "R2", "R3", "R4"]) # مناطق مشتری
model.S = pyo.Set(initialize=["low", "base", "high"]) # سناریوهای تقاضا
model.y = pyo.Var(model.J, within=pyo.Binary)
model.x = pyo.Var(model.I, model.J, model.S, within=pyo.NonNegativeReals)
model.g = pyo.Var(model.I, model.S, within=pyo.NonNegativeReals)
# ادامه قیود تأمین تقاضا، سقف ظرفیت هر انبار و تابع هدف به همین شیوه تعریف میشوند.بعد از حل مدل، ارزش گزارش «ارزش اطلاعات کامل» (EVPI) هم جالب است. این یعنی چقدر حاضریم بپردازیم تا تقاضای واقعی را از قبل بدانیم. میتوان نتیجه مدل تصادفی را با جواب هر سناریو بهتنهایی مقایسه کرد. برای نمایش شبکه نهایی، NetworkX میتواند انبارهای بازشده و مسیرهای فعال هر سناریو را بهصورت گراف رسم کند.
سوالات متداول
تفاوت این مدل با مسئله کلاسیک مکانیابی تسهیلات چیست؟
مدل کلاسیک مکانیابی فرض میکند تقاضای هر منطقه از قبل دقیقاً معلوم است. این مدل همان ساختار را حفظ میکند. اما چند سناریوی تقاضا را همزمان میبیند و تصمیم مکانیابی را در برابر همه آنها مقاوم میکند.
اگر تعداد سناریوهای تقاضا خیلی زیاد باشد چه باید کرد؟
با افزایش تعداد سناریوها، فرم گسترده مدل خیلی بزرگ میشود. در این حالت، روشهای تجزیه مثل روش ال-شکل یا نمونهگیری کوچکتر از سناریوهای نماینده (کاهش سناریو) به کار میآید.
برای یادگیری مدلسازی این نوع مسائل از کجا شروع کنم؟
دوره مسیریابی و بهینهسازی زنجیره تأمین با پایتون پایه لازم برای مدلسازی این نوع مسائل شبکه را میدهد. اگر برای پیادهسازی این مدل روی داده واقعی کسبوکارتان راهنمایی لازم دارید، از طریق صفحه مشاوره میتوانید با ما در ارتباط باشید.
مشاوره و ارتباط با ما
برای مشاوره و ثبتنام در دورهها و دریافت پروژهها با آیدی @pypyid در تلگرام در تماس باشید.
مطالب پیشنهادی
دورههای آموزشی مرتبط
آموزش مسیریابی وسایل نقلیه (VRP) با پایتون و OR-Tools
دوره پروژهمحور VRP در پایتون با OR-Tools و CP-SAT؛ ۲۰ پروژه عملی از TSP و CVRP تا VRPTW و مسیریابی خودروی الکتریکی.
دوره فشرده مدلسازی عدم قطعیت در بهینهسازی
دوره فشرده مدلسازی عدم قطعیت: مقایسه روشهای Stochastic، Fuzzy، Robust و IGDT با کاربرد در انرژی و سیستم قدرت.
آموزش پیشرفته بهینهسازی سیستم قدرت با پایتون
آموزش پروژهمحور بهینهسازی سیستم قدرت در پایتون با Pyomo: Unit Commitment، پخش بار بهینه DC و AC (OPF)، امنیت N-1، جایابی باتری و عدم قطعیت؛ ۲۲ ساعت.
دوره مدلسازی مسائل بهینهسازی
یاد بگیرید مسائل واقعی را به مدل ریاضی تبدیل کنید: متغیر تصمیم، تابع هدف، قیود و ساخت مدلهای LP، MILP و NLP با مثالهای کاربردی.
مقالات و یادداشتهای مرتبط
مکانیابی انبار: کجا بسازیم که هزینه کمتر شود؟
آشنایی با مسئله مکانیابی تسهیلات (Facility Location) در زنجیره تأمین و حل آن با ابزارهای متنباز پایتون.
اعزام آمبولانس: کدام پایگاه، به کدام حادثه، در کمترین زمان؟
چگونه بهینهسازی و مدلهای پوشش احتمالاتی به تصمیم مکانیابی پایگاه و اعزام آمبولانس در شرایط عدمقطعیت تقاضا کمک میکنند.
جابهجایی پویای آمبولانس: کجا منتظر بمانیم تا زودتر برسیم؟
آشنایی با مسئله مکانیابی و جابهجایی پویای آمبولانس در خدمات اورژانس پزشکی، و مدلسازی آن با ابزارهای متنباز پایتون.
تخصیص اسکله بندر: کدام کشتی، کجا و کِی پهلو بگیرد؟
مسئله تخصیص اسکله (Berth Allocation Problem) و مدلسازی ریاضی آن برای کاهش زمان انتظار کشتیها در بنادر با ابزارهای متنباز پایتون.
پروژههای مرتبط
جایابی باتری برای کاهش هدررفت تجدیدپذیرها
جایابی بهینه ایستگاههای ذخیرهسازی انرژی در شبکه انتقال برای کاهش هدررفت تولیدات تجدیدپذیر و بهبود بهرهبرداری با استفاده از مدلسازی ریاضی.
مدیریت انرژی شهرک با خورشیدی، باتری و خودروی برقی (V2G)
دیسپچ بهینهٔ پنل خورشیدی، باتری خانگی و مشترک، و شارژ دوطرفهٔ خودروی برقی (V2G) در یک شهرک ۷۵ خانهای، با محدودیت ظرفیت فیدر و کاهش پیک.
مسیریابی پویا (Dynamic VRP): بازبرنامهریزی زمانواقعی
سیستم مسیریابی پویا (Dynamic VRP) که با رسیدن سفارش جدید یا تغییر داده، فقط مسیر باقیماندهٔ ناوگان را در زمان کوتاه بهروزرسانی میکند.
بهرهبرداری و طراحی بهینهی سیستم انرژی-آب یکپارچه
اندازهیابی تجهیزات و بهرهبرداری ساعتی یک سیستم یکپارچهٔ بادی، خورشیدی، باتری و آبشیرینکن در افق پنجساله، با هدف کاهش هزینه و انتشار کربن.