
only_enforce_if در برابر Big-M: کدام بهتر است؟
مقایسه دو روش بیان قید شرطی در بهینهسازی عدد صحیح: تکنیک کلاسیک Big-M در برابر دستور only_enforce_if در CP-SAT، و خطر پنهان انتخاب غلط عدد M.
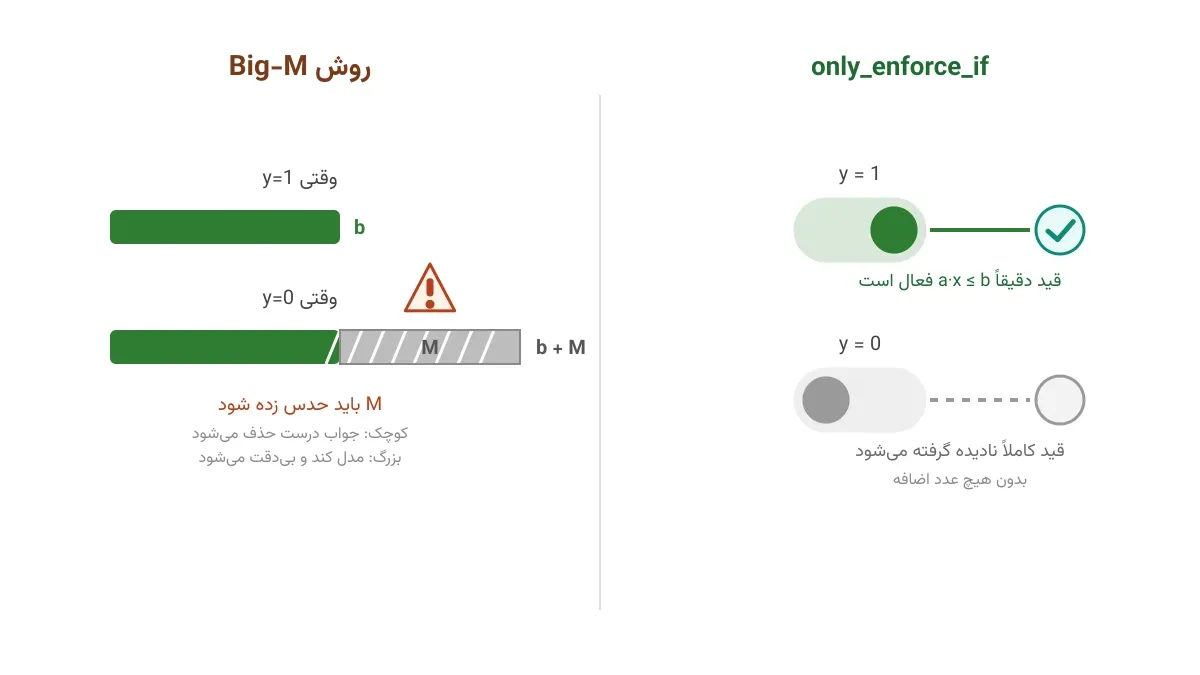
فرض کنید یک قید دارید که باید فقط گاهی برقرار باشد. مثلاً «اگر این واحد تولید برق روشن است، توانش نباید از سقف مجاز بیشتر شود». وقتی واحد خاموش است، این قید اصلاً معنا ندارد. این الگو، یعنی قید شرطی، یکی از پرتکرارترین نیازها در بهینهسازی عدد صحیح است. دو راه اصلی برای بیان آن وجود دارد. یکی ترفند کلاسیک Big-M است که در تقریباً هر کتاب برنامهریزی خطی آمده. دیگری دستور only_enforce_if در سالور CP-SAT گوگل است. این دو راه، با وجود اینکه به یک نتیجه میرسند، از نظر ریسک و دقت زمین تا آسمان فرق دارند.
چرا این موضوع اهمیت دارد
شرکتی مثل زیمنس انرژی در مدلسازی زمانبندی واحدهای تولید برق (Unit Commitment) هزاران قید شرطی از همین نوع دارد. هر واحد یک متغیر دودویی روشن/خاموش دارد و محدودیت توان فقط وقتی واحد روشن است باید اعمال شود. اگر عدد M در این مدلها اشتباه انتخاب شود، نتیجه بد است. یا یک جواب نادرست میگیریم، یا یک مدل که ساعتها طول میکشد تا حل شود. در مقیاس صنعتی، این اشتباه میتواند بهمعنای میلیونها دلار هزینه برنامهریزی غلط باشد.
فرمولبندی ریاضی: روش Big-M
فرض کنید متغیر دودویی نشان میدهد آیا قید فعال است. عبارت خطی باید فقط وقتی برقرار باشد. روش Big-M اینطور آن را مینویسد:
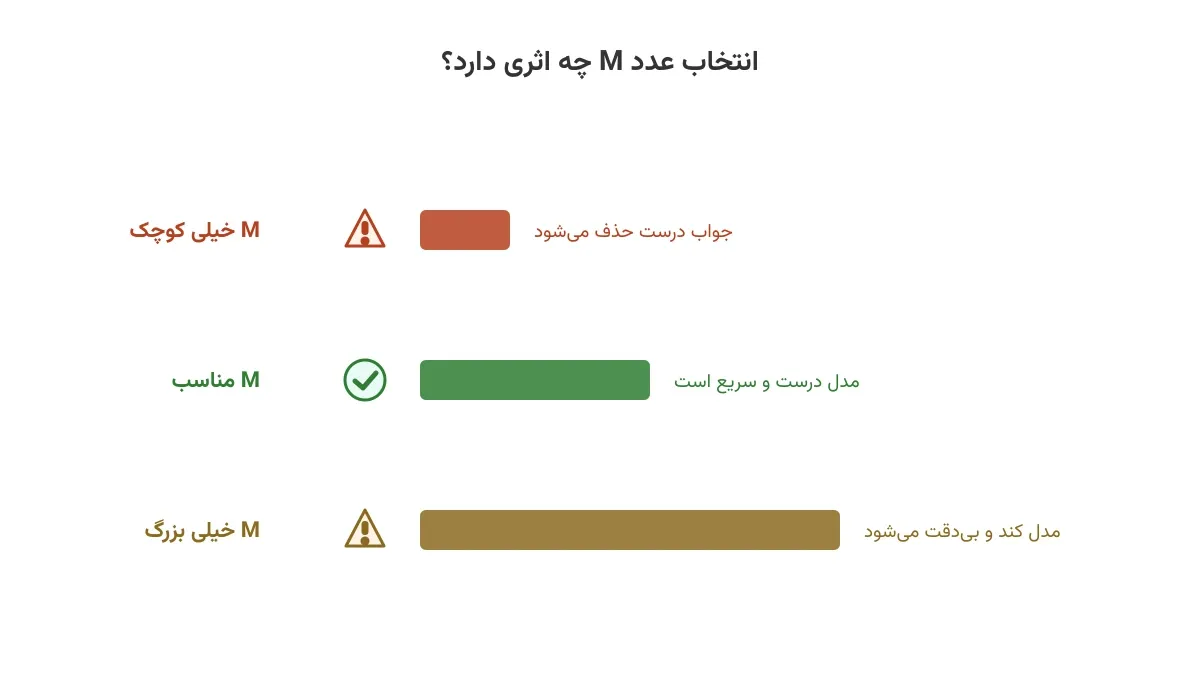
وقتی باشد، جمله صفر میشود و قید اصلی برقرار میشود. وقتی باشد، سمت راست بهاندازه بزرگ میشود. اگر بهاندازه کافی بزرگ باشد، قید عملاً بیاثر میشود. مشکل درست همینجاست: کلمه «بهاندازه کافی بزرگ» یک قضاوت دستی است، نه یک واقعیت ریاضی.
اگر کوچکتر از لازم انتخاب شود، برخی جوابهای درست بهاشتباه غیرمجاز اعلام میشوند. این یک باگ ظریف است و معمولاً هم فقط در حالت خودش را نشان میدهد. اگر خیلی بزرگتر از لازم انتخاب شود، مدل همچنان درست جواب میدهد. اما کران خطی آن (LP relaxation) آنقدر شل میشود که سالور برای اثبات بهینگی زمان زیادی صرف میکند.
فرمولبندی دوم: رایفیکیشن در CP-SAT
سالور CP-SAT یک مکانیزم بومی برای همین نیاز دارد به نام رایفیکیشن (Reification). بهجای افزودن یک عدد بزرگ، قید مستقیماً به یک متغیر منطقی گره میخورد:
در کد، این دقیقاً یک خط است: model.add(expr <= b).only_enforce_if(y). وقتی صفر باشد، سالور قید را کاملاً نادیده میگیرد، بدون اینکه هیچ عدد بزرگی وارد مدل شود. هیچ پارامتری برای تنظیمکردن وجود ندارد و هیچ ریسک کران غلط هم در کار نیست.
نکته مهم این است که only_enforce_if بهطور پیشفرض فقط «نیمهرایفیکیشن» ایجاد میکند. یعنی وقتی است قید را اجرا میکند، اما درباره حالت چیزی نمیگوید. برای رایفیکیشن کامل، باید متغیر دقیقاً معادل برقراری رابطه باشد. برای این کار، قید را یکبار برای و یکبار برای نقیض آن مینویسیم. این تفاوت کوچک، اما در مدلهای بزرگ میتواند نتیجه را کاملاً تغییر دهد.
کدام روش را انتخاب کنیم؟
اگر از CP-SAT استفاده میکنید، only_enforce_if تقریباً همیشه انتخاب بهتری است. اما این دستور مخصوص CP-SAT است. سالورهای کلاسیک برنامهریزی عدد صحیح مختلط این قابلیت را به همین شکل ندارند. مثالهایش CBC و HiGHS هستند که در Pyomo استفاده میشوند؛ این سالورها همچنان به Big-M نیاز دارند. برخی سالورهای تجاری مثل Gurobi و CPLEX قیدهای اندیکاتور بومی دارند که شبیه رایفیکیشن عمل میکنند. اما این یک استثنا است، نه قاعده. یادداشت سه روش عملی استفاده از سالورها در Pyomo این سالورها را معرفی میکند. با خواندن آن میبینید انتخاب سالور چقدر روی نوشتن مدل اثر میگذارد.
ظرفیت کار آکادمیک و پژوهشی
تنگکردن کران Big-M (Tightening the Big-M) خودش یک حوزه پژوهشی مستقل در بهینهسازی عدد صحیح است. هدف پیدا کردن کوچکترین معتبر برای هر قید، بهجای یک عدد ثابت و محافظهکارانه برای کل مدل است. این مسئله به تحلیل حساسیت و برنامهریزی خطی کمکی برای هر قید نیاز دارد.
زاویه پژوهشی دیگر، مقایسه تجربی قدرت کران دوگان (LP bound) بین فرمولبندی Big-M و فرمولبندی مبتنی بر قید اندیکاتور است. این مقایسه نشان میدهد چرا برخی مدلهای معادل ریاضی، از نظر سرعت حل چند مرتبه با هم فرق دارند. یادداشت تشخیص مدل غیرممکن هم به این موضوع اشاره کرده است.
پیادهسازی با پایتون
خوشبختانه آزمایش هر دو روش روی یک مثال کوچک، چند دقیقه بیشتر طول نمیکشد. در این مثال از OR-Tools گوگل و ماژول CP-SAT آن استفاده میکنیم، چون only_enforce_if مستقیماً در این کتابخانه پیادهسازی شده است.
from ortools.sat.python import cp_model
model = cp_model.CpModel()
y = model.new_bool_var("unit_on")
power = model.new_int_var(0, 1000, "power")
# روش only_enforce_if: بدون هیچ عدد جادویی
model.add(power <= 300).only_enforce_if(y)
# ادامه قیدهای روشن/خاموش، هزینه راهاندازی و تابع هدف به همین شیوه اضافه میشوندسوالات متداول
آیا Big-M همیشه اشتباه است؟
نه. وقتی کران واقعی مسئله مشخص باشد، Big-M کاملاً درست و کارآمد کار میکند. مشکل فقط وقتی شروع میشود که این کران حدس زده شود.
چطور بفهمم مدل من از Big-M رنج میبرد؟
اگر سالور شما زمان زیادی روی اثبات بهینگی صرف میکند اما جوابهای نزدیک به هم زود پیدا میشوند، کرانهای Big-M شل یکی از مظنونان اول هستند. دوره مبانی مدلسازی ریاضی و بهینهسازی با پایتون این نوع تشخیص را هم پوشش میدهد.
برای مدل خاص خودم کدام روش را استفاده کنم؟
این بستگی به سالور و اندازه مدل شما دارد و معمولاً نیاز به بررسی دقیقتری دارد. برای این کار میتوانید از طریق مشاوره با من در تماس باشید.
مشاوره و ارتباط با ما
برای مشاوره و ثبتنام در دورهها و دریافت پروژهها با آیدی @pypyid در تلگرام در تماس باشید.
مطالب پیشنهادی
دورههای آموزشی مرتبط
دوره مدلسازی مسائل بهینهسازی
یاد بگیرید مسائل واقعی را به مدل ریاضی تبدیل کنید: متغیر تصمیم، تابع هدف، قیود و ساخت مدلهای LP، MILP و NLP با مثالهای کاربردی.
دوره جامع بهینهسازی و تصمیمگیری سیستم سلامت با پایتون
دوره جامع و پروژه محور بهینهسازی و تصمیمگیری سیستم سلامت با پایتون و OR-Tools؛ ۲۰ پروژه عملی از تخصیص تخت بیمارستان تا امداد پهپادی به مناطق آسیبدیده.
آموزش مسیریابی وسایل نقلیه (VRP) با پایتون و OR-Tools
دوره پروژهمحور VRP در پایتون با OR-Tools و CP-SAT؛ ۲۰ پروژه عملی از TSP و CVRP تا VRPTW و مسیریابی خودروی الکتریکی.
دوره فشرده مدلسازی عدم قطعیت در بهینهسازی
دوره فشرده مدلسازی عدم قطعیت: مقایسه روشهای Stochastic، Fuzzy، Robust و IGDT با کاربرد در انرژی و سیستم قدرت.
مقالات و یادداشتهای مرتبط
مدل غیرقابلاجرا: چطور قید مقصر را پیدا کنیم؟
معرفی روشهای تشخیص هستهی تناقض در مدلهای بهینهسازی غیرقابلاجرا (Infeasible) و پیادهسازی آن با OR-Tools CP-SAT در پایتون.
حل همه جوابها با OR-Tools
آموزش پیدا کردن همه جوابهای یک مدل با Constraint Programming در OR-Tools؛ همراه با یک مثال ساده و قابل اجرا در Python برای درک enumerate کردن جوابها.
سه روش عملی استفاده از Solverها در Pyomo
سه روش عملی نصب و استفاده از سالورهای Pyomo؛ راهنمای انتخاب میان HiGHS، CBC، IPOPT و Gurobi برای مسائل خطی، صحیح و غیرخطی مختلف.
اعزام آمبولانس: کدام پایگاه، به کدام حادثه، در کمترین زمان؟
چگونه بهینهسازی و مدلهای پوشش احتمالاتی به تصمیم مکانیابی پایگاه و اعزام آمبولانس در شرایط عدمقطعیت تقاضا کمک میکنند.
پروژههای مرتبط
جایابی باتری برای کاهش هدررفت تجدیدپذیرها
جایابی بهینه ایستگاههای ذخیرهسازی انرژی در شبکه انتقال برای کاهش هدررفت تولیدات تجدیدپذیر و بهبود بهرهبرداری با استفاده از مدلسازی ریاضی.
زمانبندی بازرسی قصابیها با OR-Tools
مدلسازی و حل مسئله زمانبندی بازرسی قصابیها با OR-Tools در پایتون؛ یک مثال عملی از Task Scheduling و تخصیص بهینه بازرسها.
مدیریت انرژی شهرک با خورشیدی، باتری و خودروی برقی (V2G)
دیسپچ بهینهٔ پنل خورشیدی، باتری خانگی و مشترک، و شارژ دوطرفهٔ خودروی برقی (V2G) در یک شهرک ۷۵ خانهای، با محدودیت ظرفیت فیدر و کاهش پیک.
مسیریابی پویا (Dynamic VRP): بازبرنامهریزی زمانواقعی
سیستم مسیریابی پویا (Dynamic VRP) که با رسیدن سفارش جدید یا تغییر داده، فقط مسیر باقیماندهٔ ناوگان را در زمان کوتاه بهروزرسانی میکند.